
当“把积木放进碗里”的任务教导,分别下达给部署在真正机械臂上的GPT-6 Astra和Claude Fable 5.1时,在20次测试中,二者的奏效次数分别为19次和8次kaiyun网站,对应奏效率95%和40%。但当任务细化为“把拼图块插入对应的凹槽”时,GPT-6 Astra的奏效率滑落至10%。
这是近期零丁第三方机器东说念主基准测试平台Robocurve公布的一项实测限度。限度标明,顶尖大模子照旧展现出操控物理开发的技艺,但在概述操作层面仍存在短板。而这亦然具身智能落地真正场景亟待打破的贫瘠:机器东说念主不仅要能听懂教导,更需要具备感知环境、会通空间、自主有策划的技艺。
在这一配景下,具身智能赛说念的头部企业正试图给出解题念念路。9月10日,宇树科技告示王人备开源新一代通用东说念主形机器东说念主基础模子UnifoLM-WLA-1.0,该模子依托大限制通用多模态感知与会通数据,交融以交互为中心的寰球建模,全面擢起飞间感知与会通技艺。在多项具身推理评测中,其发达最初国表里开源模子,亦可并排头部闭源模子,象征着通用东说念主形基础模子规模迎来首要打破。
2500小时真机数据查验,单模子销毁64项任务
往常数年,机器东说念主模子的查验大多聚焦单项任务、单一机器东说念主内容及固定操作场景。一朝更换任务或调理环境,不异需要从头网罗数据并进行查验。面前,NVIDIA GR00T、Figure Helix、Physical Intelligenceπ系列等具身智能基础模子,均勤勉于于擢升跨任务、跨环境与跨内容移动中的泛化技艺。打造通用“具身大脑”、买通多场景功课技艺,照旧成为行业角逐的焦点。
宇树科技也服从擢升模子的泛化技艺、数据附近后果和强化学习的限制效应。宇树科技告示开源UnifoLM-WLA-1.0,代码、模子权重与数据集将不时洞开。据公司先容,该模子参数目为6B,附近2500小时高质料真机网罗数据查验,销毁多种机器东说念主内容与功课场景,包括宇树开源数据以选取三方机器东说念主数据。一套模子即可完成64项相反化任务。模子兼容二指夹爪与两类颖异手,复古不同终端奉行器切换。
左证宇树给出的真机实验限度,搭载该模子的机器东说念主可协同调遣双臂、终端奉行器与下半身,完成包括54项桌面操作任务以及10项全身移动操作任务。桌面场景触及收纳餐盘、电板充电等需要概述操作的任务;全身移动操作则蔓延至垃圾处分、鞋子整理、沙发整理以及在较大空间范围内取放物品等场景。
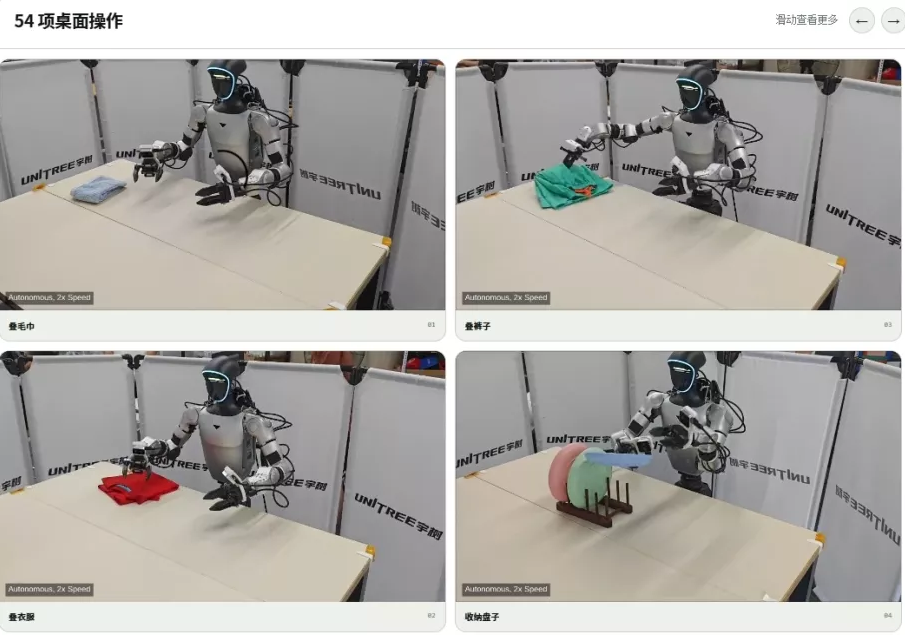
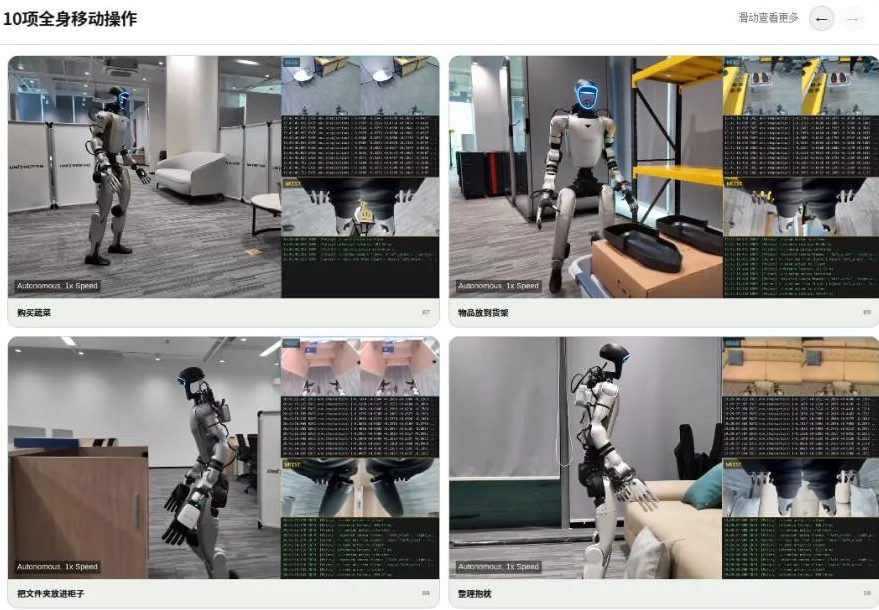
这种“一模运行、全身协同”的联想,不仅裁汰了针对不同机器东说念主内容和特定场景的查验资本,还显耀擢升了模子在洞开环境中的教导会通技艺和跨任务泛化技艺,有望为通用东说念主形机器东说念主的限制化落地奠定手艺基础。
多项具身推理策划最初,让机器东说念主“会通寰球”
机器东说念主要在真正环境中结束“看得懂、摸得准、干得稳”,离不开对物理寰球的感知与会通技艺。比喻,机器东说念主奉行整理房间、铺床、整理厨房物品等任务时,不异需要左证物体状况和空间位置调理动作;当物体被移动、折叠或提起后,环境也会随之发生篡改,后续有策划需要修复在更新后的场景状况之上。
围绕这一问题,宇树科技为UnifoLM-WLA-1.0联想了一套“具身推理+异日变化瞻望+动作学习”体系:机器东说念主既要会通面前看到的空间和物体,也要瞻望一次交互可能让场景中的什么地方发生变化,再生成具体动作。
具身推理层面,宇树科技先容,手脚UnifoLM-WLA-1.0的具身推理模块,UnifoLM-ER-1-4B基于Qwen3-VL-4B,继承卓越500万条查验数据,销毁图像点瞻望、地点检测、多图推理、2D轨迹瞻望、3D地点检测及多图空间问答等任务,并与通用图文数据夹杂查验,在保捏通用视觉话语技艺的同期,全面擢升具身场景下的空间会通与推理技艺。
左证宇树科技公布的16项多模态感知和会通评测限度,UnifoLM-ER-1-4B在7项评测中最初其他模子。举例,其在Where2Place测试中赢得82.0分,比GPT-6 Astra进步13分;Pixmo-Point为73.8分,BLINK达93.4分,EmbSpatial为88.9分,反应出模子在空间感知、场景会通等维度的系统性上风。
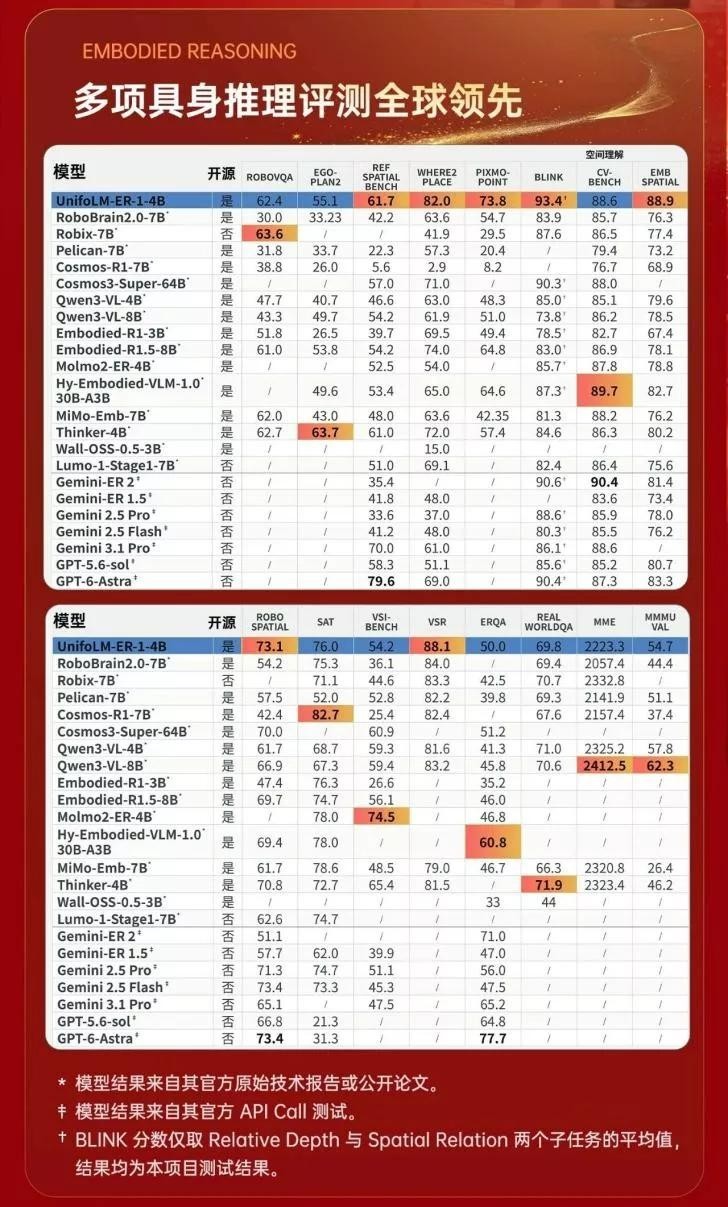
除了全面擢起飞间会通与推理技艺,UnifoLM-WLA-1.0 进一步强化机器东说念主的“瞻望”技艺,让机器东说念主在行动前“多想一步”。宇树科技先容,模子以图像以及任务描写或动手脚要求,瞻望异日场景的动态区域;查验流程中,使用光流索取异日场景变化区域手脚监督信号,得到UnifoLM-ER-Flow模子。渊博而言,该模子让机器东说念主不仅能会通环境,也能想象和瞻望环境将怎样变化,并生成可奉行的行动计谋。
在龙套动作学习方面,宇树将合股动作空间差别为终端奉行器位姿、终端奉行器要道量和下肢领路要道量三个部分,再通过残差矢量量化(RVQ)模子将一语气动作漂流为龙套token。不同形体部分的token按照分享时候步对王人后送入模子,从而学习终端奉行器位姿、夹爪或颖异手要道以及下肢动作之间的协同计划。肤浅来说,这一步是把机器东说念主一语气、丝滑的动作“拆解”成一个个可被模子学习和复用的动作单位,就像把一段视频拆成裂缝帧来学习。
上述架构联想,组成该模子“会通寰球,不绝行动”的基础。通过感知会通、交互限度瞻望和动作生成三个顺次,UnifoLM-WLA-1.0让东说念主形机器东说念主在靠近现实环境和复杂教导时,具备更强的合适性与有策划浮现性,鼓励具身智能从“默契智能”向“行动智能”进阶。
东说念主形机器东说念主迈入“大脑竞赛”阶段,宇树加码具身智能模子
宇树科技独创东说念主王兴兴在2026寰球机器东说念主大会上暗示,面前环球东说念主形机器东说念主产业最大的瓶颈是具身智能的泛化技艺不及,中枢问题在于AI模子的输入输出与真正物理寰球的对王人程度不够。
现实上,宇树科技比年来捏续攻坚具身大模子、场景数据网罗与分析、强化学习等裂缝手艺,同期布局WMA(World-Model-Action,寰球模子-动作)与VLA(视觉-话语-动作架构)两大手艺道路。按照公司野心,其地点是逐步具备场景泛化、教导泛化、动作泛化与任务泛化技艺,并酿成“云表模子查验—端侧推理奉行—线上数据网罗”的闭环。
宇树科技这一动作并非孤例。面前,环球科技巨头正加快布局物理AI赛说念,行业竞争的焦点已从单一的硬件性能比拼,转向以数据限制、算法泛化技艺及多模态会通为中枢的“大脑”较量。
在这一进度中,开源生态已成为推动手艺普惠与快速迭代的裂缝力量。此前,宇树科技已分别开源了通用WMA(寰球模子-动作)大模子“UnifoLM-WMA-0”和通用东说念主形机器东说念主操作的视觉-话语-动作(VLA)大模子“UnifoLM-VLA-0”。
这次公司王人备开源UnifoLM-WLA-1.0,不仅展示了其在具身智能“大脑”规模的硬实力,更有望构建“器用链—开发者—应用—数据”的生态闭环,引诱更多开发者参与底层算法优化与场景应用革命kaiyun网站,加快东说念主形机器东说念主从实验室走向千行百业。